APUS Reflex Agent 深度解析:用决策模型做 Harness,让 Agent 快 3 倍、不「失忆」
APUS Reflex Agent 深度解析:用决策模型做 Harness,让 Agent 快 3 倍、不「失忆」
项目地址:https://github.com/APUS-AI-Lab/APUS-Reflex-Agent
决策模型:https://huggingface.co/apus-ailab/APUS-Reflex
协议:MIT(桌面端 / Web / SDK 全部开源)
一、为什么要关注这个项目?
2026 年 10 月 13 日晚,APUS AI(麒麟合盛)开源了一个叫 Reflex Agent 的 Personal Agent(个人智能体)产品。
跟 Claude Code、Codex、Cursor 这些主流 Agent 不同,它提出了两个反直觉的设计:
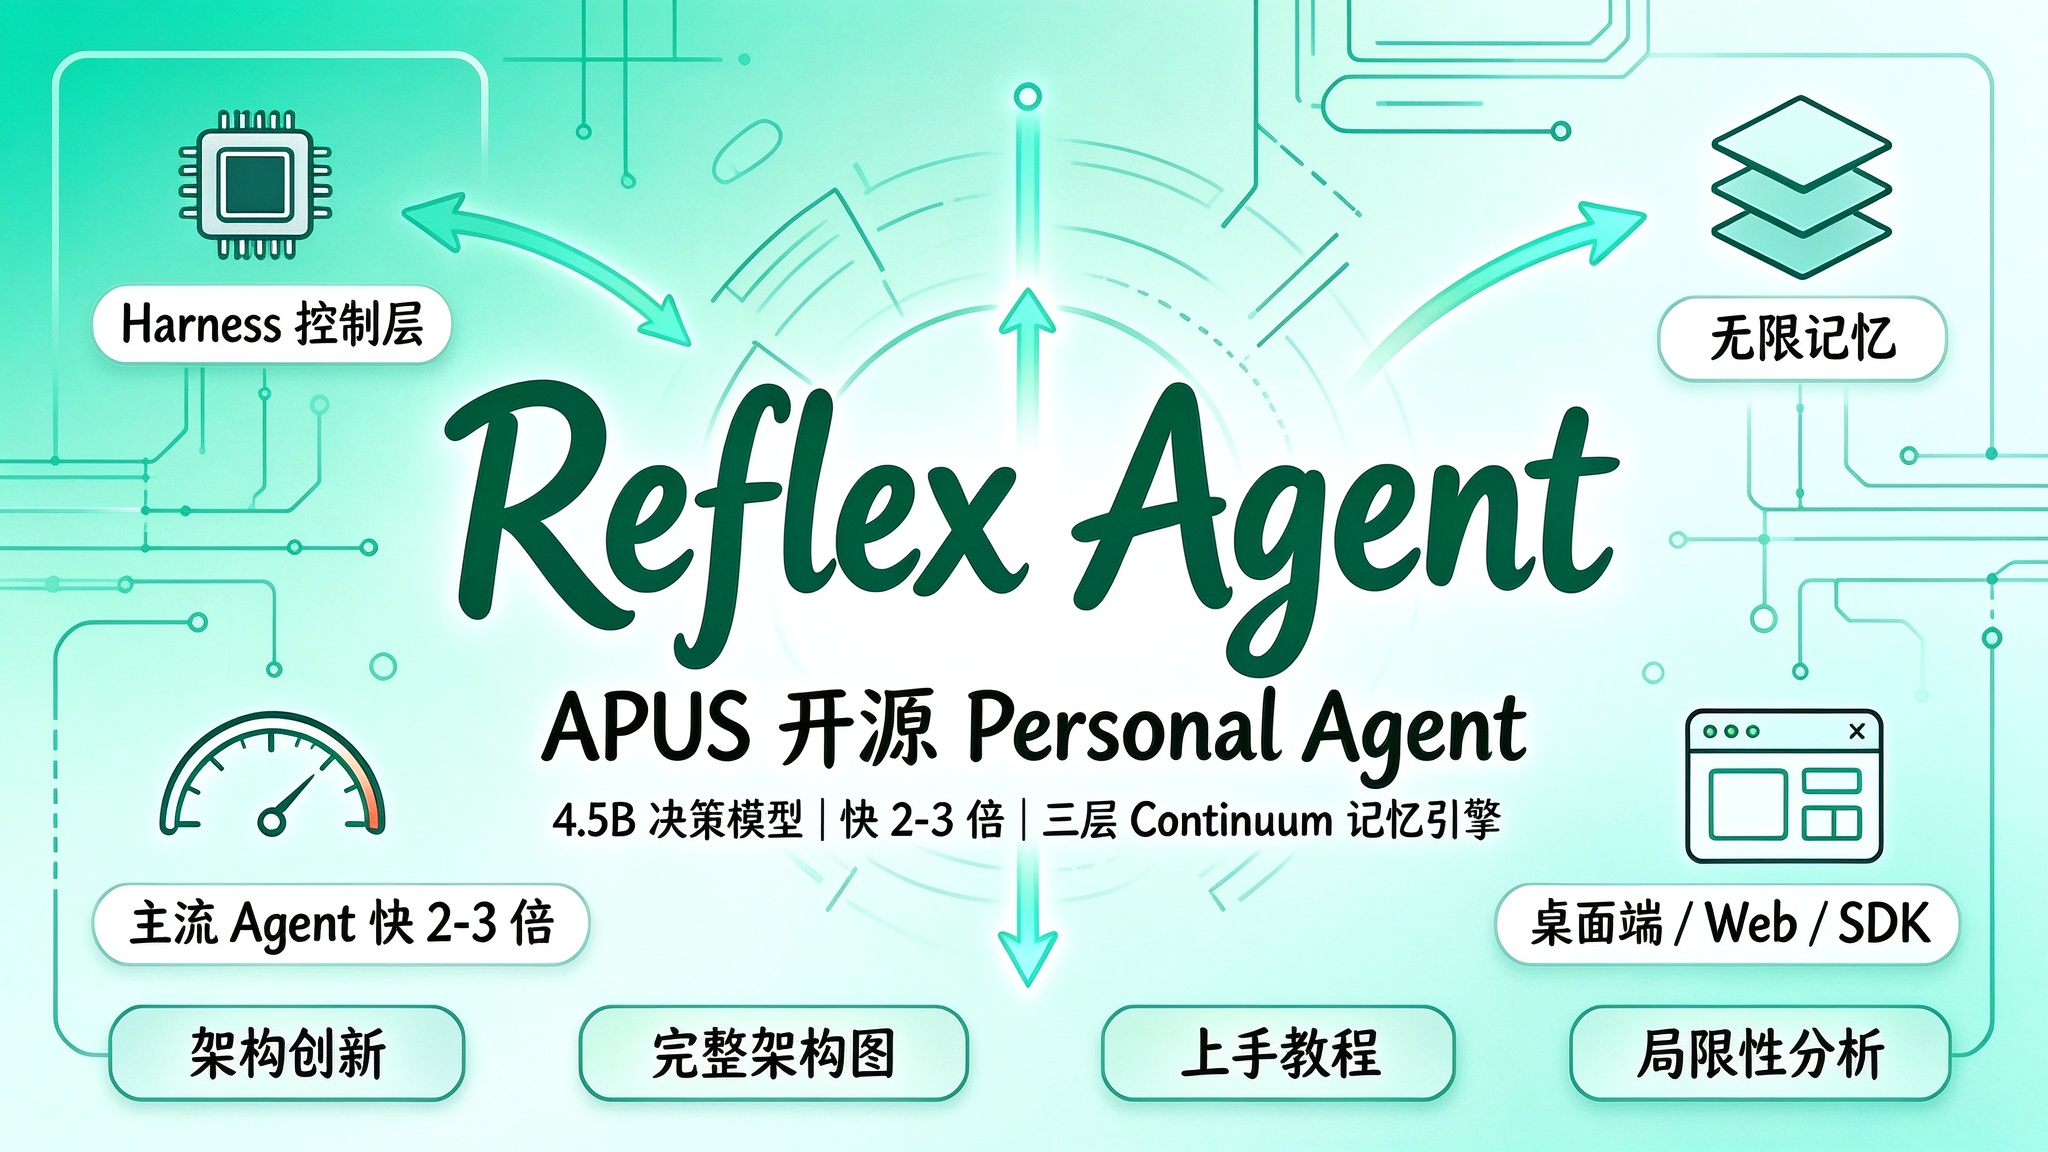
- 不把所有决策都交给大模型——用一个 4.5B 的小模型(基于 Qwen3.5 微调)专门做 Harness 层的控制决策,响应速度实测能比主流 Agent 快 2-3 倍;
- 不靠压缩历史凑上下文——搭了一套叫 Continuum 的三层记忆引擎,实现无限记忆 + 无损记忆 + 无损输入,彻底换了一条解决"长任务失忆"的思路。
它不是又一个 Prompt 包装,而是一次 Harness 架构层面的重构。正在准备 Agent 工程师方向面试的同学,这套架构思路值得认真拆一遍。
二、先搞清楚两个痛点:慢 & 失忆
APUS 在开源公告里直接点出了当前 Agent 行业的两个硬伤:
痛点 1:大模型每想一步,用户就多等一步
主流 Agent 几乎都是"提示词 + 代码"搭的 Harness(执行框架)。每一步控制决策——"这个需求该交给谁执行"、"调哪个工具"、"任务做完没有"——都要调用大模型来判断。
在浏览器操作、多工具链式调用、连续工作流这类高频决策场景,每多一次 LLM 调用,就是一次网络往返 + 推理延迟,用户体感就是"卡"。
痛点 2:长任务里 Agent 总是「失忆」
任务一长,历史就超出上下文窗口。行业通行做法是把旧对话压成摘要塞进 prompt。问题是:细节、出处、原始约束往往在压缩过程中丢掉了,等你需要 Agent 回溯某个条件、核对原始信息、修正之前判断时,摘要里压根找不到。
这两个痛点看似独立,本质是同一个问题:当前 Agent 架构把"决策"和"执行"都压在了同一个大模型身上,导致它既要快又要记全,但两头都做不好。
三、核心解法一:用模型做 Harness(Model-Driven Harness)
Reflex Agent 的第一个创新,是把 Harness 里的"决策判断"独立出来,用一个专用小模型承担。
3.1 三层角色分工
| 层 | 承担者 | 干什么 |
|---|---|---|
| 决策层 | Reflex 模型(4.5B,基于 Qwen3.5 微调) | 模型路由、技能选择、结果审查、执行监督——判断"下一步干什么" |
| Harness 层 | 调度框架 | 流程调度、工具管理、状态跟踪、接收执行反馈——"怎么把决策落实" |
| 工具层 | 外部工具 / 大模型 / 数据 | 具体干活——写代码、查资料、操作浏览器 |
这跟目前主流做法的关键区别在于:决策模型只做判断,不做内容生成。需要生成内容或调用外部能力时,它再按需路由到合适的大模型或工具。
3.2 Loop Working 闭环
APUS 把这套工作循环命名为 Loop Working(循环工作):
决策 → 执行 → 反馈 → 再决策 → ……(循环直到任务完成)
决策模型是整个流程的控制中枢,大模型是被它按需调用的"打工人"。
这不是简单的"换个小模型",而是重新划分了模型和 Harness 的职责边界。APUS 给出的实测数据是:在需要连续操作、频繁调用工具的复杂任务场景里,页面响应速度比 Claude Code、Codex 这类主流 Agent 快 2-3 倍。
3.3 为什么小模型能做决策?
Reflex 决策模型是专门针对三类任务微调的:
- 浏览器动作选择(点哪个按钮、填哪个表单)
- 工作流路由(任务该交给哪个工具/子 Agent)
- 自然语言原则判断(任务是否完成、结果是否合规)
这些决策是模式化、可枚举、可训练的——4.5B 的小模型足够胜任,而且推理延迟比千亿模型低一个数量级。内容生成、复杂推理才交给大模型。
这个思路其实和 Harness Engineering 近期的演化方向一致:行业已经意识到,"Agent = LLM + Harness",而 Harness 本身需要专门的工程设计,不能全靠 Prompt 硬撑。
四、核心解法二:Continuum 记忆引擎(无限上下文)
第二个创新是记忆系统。Reflex Agent 搭了一个叫 Continuum 的三层记忆引擎,从根本上换了"上下文怎么进模型"的思路。
4.1 三层记忆机制
| 层 | 名字 | 干什么 |
|---|---|---|
| L1 | 无限记忆(Infinite Memory) | 持续累积任务全量信息,给长周期任务提供完整记忆底座——不删、不丢 |
| L2 | 无损记忆(Lossless Memory) | 完整保存原始信息和关联关系,支持随时回溯任务细节、历史判断依据——不压、不改 |
| L3 | 无损输入(Lossless Input) | 检索调入当前决策上下文的信息保留原文,不做有损改写、不生成摘要 |
关键在第三层。传统 RAG/摘要方案在"检索到信息后"往往还要过一道摘要/压缩,这正是细节丢失的地方。Continuum 的做法是:检索到的原始内容直接进入决策上下文,模型自己判断怎么用。
4.2 工作方式:不塞全量,按需检索
Agent 不需要把全部历史一次性塞进 prompt,而是:
- 当前决策需要什么信息 → 通过语义检索找相关记忆片段
- 把原文片段直接注入决策上下文
- 决策模型基于原始信息(不是摘要)判断下一步
这让"上下文长度"不再等同于"单次 prompt 能塞多少 token",而是记忆库有多大,Agent 的上下文就能有多大——APUS 称之为真正的"无限上下文"(注意:不是突破单次模型调用的输入长度限制,而是让记忆与任务周期不再受单次窗口限制)。
4.3 和主流方案对比
| 方案 | 历史处理方式 | 缺点 |
|---|---|---|
| 滑动窗口 | 直接截断早期内容 | 直接丢信息 |
| 摘要压缩(主流) | LLM 把历史压成摘要 | 细节和出处丢失 |
| 向量 RAG | 检索相关片段 + 可能再摘要 | 摘要环节仍有损 |
| Continuum(Reflex) | 全量保存 + 检索原文直入 | 存储成本高,但信息保真 |
五、完整架构图(概念版)
┌─────────────────────────────────────────────────────┐
│                    用户指令                          │
└──────────────────────┬──────────────────────────────┘
                       ▼
┌─────────────────────────────────────────────────────┐
│           Reflex 决策模型(4.5B 小模型)             │
│   路由决策 / 工具选择 / 完成审查 / 执行监督           │
└───┬─────────────────┬─────────────────┬─────────────┘
    │                 │                 │
    ▼                 ▼                 ▼
┌─────────┐    ┌─────────────┐   ┌──────────────┐
│ 工具集  │    │  内容大模型  │   │  外部数据/API │
│(浏览器/ │    │(GPT/Claude/ │   │  (搜索/数据库 │
│ 文件/   │    │ DeepSeek等) │   │   /企业系统)  │
│ Shell)  │    └──────┬──────┘   └──────┬───────┘
└────┬────┘           │                 │
     │                │                 │
     └─────────┬──────┴─────────────────┘
               ▼
┌─────────────────────────────────────────────────────┐
│           Harness(流程调度 / 状态跟踪)             │
└──────────────────────┬──────────────────────────────┘
                       ▼
┌─────────────────────────────────────────────────────┐
│          Continuum 记忆引擎(三层记忆)              │
│  无限记忆 ←→ 无损记忆 ←→ 无损输入(原文直入)        │
└──────────────────────┬──────────────────────────────┘
                       │
                       └──→ 反馈给决策模型,进入下一轮
                           (Loop Working 循环)
六、快速上手教程
Reflex Agent 提供三种使用形态:桌面端(开箱即用 GUI)、Web 端(自托管)、SDK(嵌入自己的应用)。下面分别说明。
6.1 前置准备
- Python 3.10+(SDK 必需)
- Node.js 18+(Web 端自托管)
- 至少一个大模型 API Key(OpenAI / Anthropic / DeepSeek / APUS 天燕大模型均可)
- (可选)GPU 环境本地跑 Reflex 决策模型;无 GPU 可调用 APUS 托管的 Reflex 推理接口
6.2 方式一:桌面端(最快体验)
- 前往 GitHub Releases 页 下载对应系统的安装包(macOS / Windows / Linux)
- 安装后首次启动,进入设置页填入大模型 API Key
- 在主界面选择任务类型(浏览器操作 / 文件处理 / 研究助手等),或直接输入自然语言任务
- Agent 会自动启动 Loop Working 循环:决策模型判断下一步 → 调用工具/大模型执行 → Continuum 记录全过程 → 反馈继续
桌面端适合:普通用户想体验 Personal Agent、不想碰代码的场景。
6.3 方式二:Web 端自托管
# 1. 克隆仓库
git clone https://github.com/APUS-AI-Lab/APUS-Reflex-Agent.git
cd APUS-Reflex-Agent/web

# 2. 安装依赖
npm install

# 3. 配置环境变量
cp .env.example .env
# 编辑 .env,填入 LLM_API_KEY、REFLEX_MODEL_ENDPOINT 等

# 4. 启动
npm run dev
# 默认访问 http://localhost:3000
生产部署建议用 Docker:
docker build -t reflex-agent .
docker run -p 3000:3000 \
  -e LLM_API_KEY=your_key \
  -e REFLEX_MODEL_ENDPOINT=your_endpoint \
  -v reflex_data:/app/data \
  reflex-agent
Web 端适合:团队内部部署、多人共享使用。
6.4 方式三:Python SDK 集成(开发者重点)
SDK 是把 Reflex Agent 嵌入你自己应用的主要方式。
pip install reflex-agent-sdk
最小可运行示例:
from reflex_agent import Agent, AgentConfig
from reflex_agent.memory import ContinuumMemory
from reflex_agent.tools import BrowserTool, FileTool, ShellTool

# 1. 配置 Agent
config = AgentConfig(
    # 决策模型:本地路径或 APUS 托管 endpoint
    decision_model="apus-ailab/APUS-Reflex",
    # 内容大模型:替换为你自己的 API
    content_model={
        "provider": "openai",
        "model": "gpt-4o",
        "api_key": "sk-xxx",
    },
    # Continuum 记忆引擎
    memory=ContinuumMemory(
        storage_path="./reflex_memory",  # 记忆本地存储路径
        enable_infinite=True,            # 开启无限记忆
        enable_lossless_input=True,      # 开启无损输入(原文直入)
    ),
)

# 2. 创建 Agent 实例,注册工具
agent = Agent(config)
agent.register_tool(BrowserTool())   # 浏览器操作
agent.register_tool(FileTool())      # 文件读写
agent.register_tool(ShellTool())     # 命令行

# 3. 给一个任务,Agent 自动进入 Loop Working
result = agent.run(
    "帮我整理桌面上所有 PDF 文件,按主题分类到不同文件夹,"
    "然后生成一份内容摘要索引表"
)

print(result.summary)
6.5 核心 SDK 接口一览
| 接口 | 作用 |
|---|---|
Agent(config) | 创建 Agent 实例 |
agent.register_tool(tool) | 注册自定义工具 |
agent.run(task) | 同步执行任务(阻塞到完成) |
agent.run_async(task) | 异步执行,支持流式回调 |
agent.memory.query(question) | 直接查询记忆库(检索原文) |
agent.memory.export() | 导出全量记忆(JSON) |
agent.add_observer(callback) | 添加执行过程观察者(调试/日志) |
6.6 自定义工具示例
from reflex_agent import BaseTool

class SendEmailTool(BaseTool):
    name = "send_email"
    description = "给指定收件人发送邮件"

    def execute(self, to: str, subject: str, body: str) -> str:
        # 这里写你自己的邮件发送逻辑
        print(f"发送邮件给 {to}: {subject}")
        return f"邮件已发送给 {to}"

agent.register_tool(SendEmailTool())
注册后,Reflex 决策模型会自己判断什么时候调用它,不需要手写工作流。
七、典型应用场景
Reflex Agent 的设计定位是 Personal Agent(个人智能体),在以下场景优势明显:
| 场景 | Continuum 怎么帮忙 |
|---|---|
| 长期研究助理 | 跨多周收集资料,不丢任何文献细节,随时能回溯某篇论文的具体说法 |
| 浏览器自动化 | 多步骤网页操作(填表、爬数据、下单),小模型决策快,连续操作不卡顿 |
| 代码审查 Agent | 跨多个 PR、多个分支记住历史评论和项目规范,不会"忘了上次说过什么" |
| 个人数字管家 | 长期记住你的偏好、日程、习惯,越用越懂你(而不是每次都从零开始) |
| 企业内部知识助手 | 无损读取企业文档原文,避免摘要把合同条款、财务数字改写出错 |
八、和主流 Agent 方案对比
| 维度 | Claude Code / Codex | LangGraph / AutoGPT 类 | Reflex Agent |
|---|---|---|---|
| 决策方式 | 大模型全包 | 大模型 + 代码规则 | 小模型做决策,大模型做内容 |
| 决策延迟 | 高(每步 LLM 调用) | 中 | 低(小模型快 2-3 倍) |
| 长任务记忆 | 上下文窗口 / 摘要 | 向量库 + 摘要 | 三层 Continuum,原文直入 |
| 记忆保真 | 有损 | 有损 | 无损 |
| 部署形态 | 云端 CLI | 自建 | 桌面 / Web / SDK 全开源 |
| 协议 | 闭源 / 部分开源 | 开源 | MIT 全开源 |
| 定位 | 编程 Agent | 通用 Agent 框架 | Personal Agent 产品 |
九、局限与值得思考的地方
我不想光吹,几个需要注意的点:
- "快 3 倍"是 APUS 实验室数据,真实场景里能快多少,还要等社区实测;不同任务类型差异会很大。
- 无损输入意味着 token 消耗可能更高——原文直入比摘要费 token,长任务的 API 成本需要权衡。
- 决策模型是 4.5B 小模型,在复杂、多跳、开放式决策场景下,判断力和千亿模型比肯定有差距;APUS 的策略是"判断不准时路由给大模型",但这个 fallback 边界怎么划,还有待验证。
- 项目刚开源(2026-10-13),生态、文档、社区都还在早期,生产用建议先观望或小范围试点。
- "无限上下文"是工程概念,不是物理突破——它绕开了单次 prompt 长度限制,但检索质量、记忆索引效率、长期存储成本都是新的工程挑战。
十、对 Agent 工程师的启示
如果你正在准备 Agent 方向面试,或者正在设计自己的 Agent 系统,Reflex Agent 给出了两个非常值得借鉴的思路:
思路 1:决策与执行解耦
不要让同一个大模型承担"判断做什么"和"动手做"两件事。高频、模式化的决策可以下沉给小模型甚至规则系统,大模型只在需要创造力、复杂推理时出手。这不仅是速度问题,也是成本和稳定性问题。
思路 2:记忆系统不要只靠摘要
摘要压缩是当前最偷懒也最普遍的做法,但它在信息保真上有根本性缺陷。原文检索 + 无损注入这条路虽然存储和 token 成本更高,但在需要精确回溯的场景(合同、代码、研究、医疗、金融)几乎是必须的。Continuum 的三层设计可以作为你设计记忆系统时的参考模板。
这两点正好对应了 Harness Engineering 里两个核心子系统:Context / Lifecycle 编排 和 Memory 工程。
本文基于 APUS 官方开源公告、智东西、品玩、经济参考报、环球网等公开报道及项目技术资料整理,不构成任何技术采用或投资建议。项目刚开源,部分细节(SDK 具体 API、部署配置等)可能随版本迭代变化,请以 GitHub 官方文档为准。